

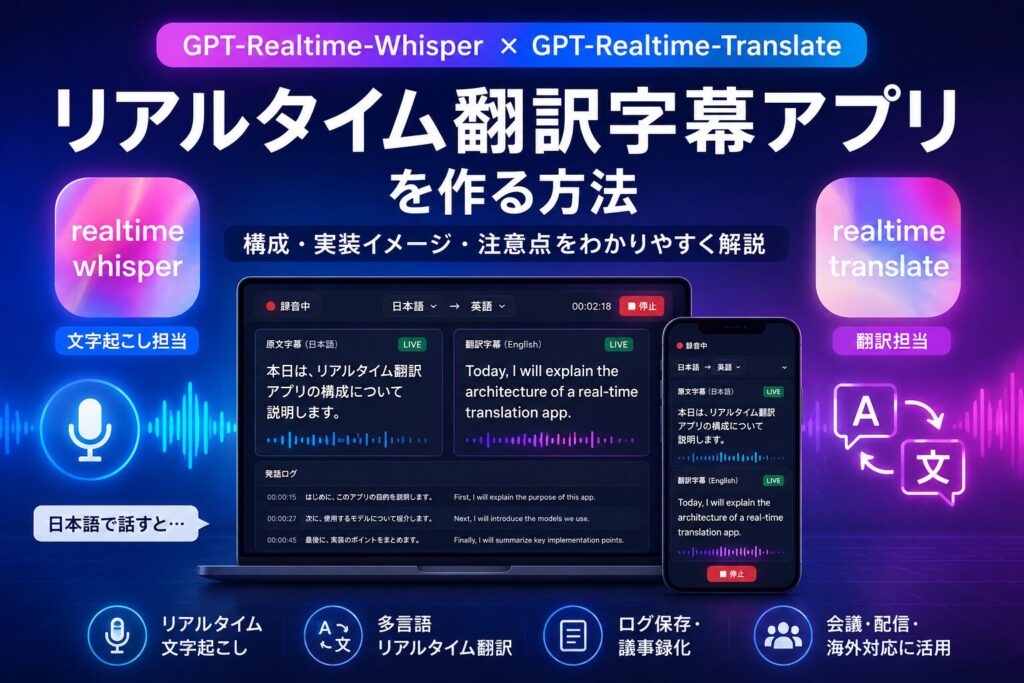
音声AIの進化により、話した内容をその場で文字起こしし、別の言語へ翻訳するアプリを作りやすくなっています。OpenAIのGPT-Realtime-WhisperとGPT-Realtime-Translateを組み合わせれば、会議、配信、海外対応などに使えるリアルタイム翻訳字幕アプリを実装できます。本記事では、モデルの概要よりも、アプリ制作の構成や実装時の考え方を中心に解説します。
GPT-Realtime-WhisperとGPT-Realtime-Translateの役割
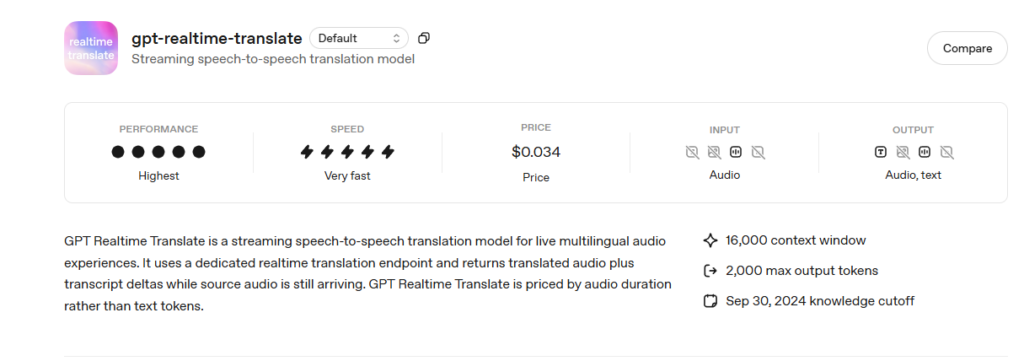
GPT-Realtime-WhisperとGPT-Realtime-Translateは、どちらも音声をリアルタイムに扱うためのモデルですが、担当する役割が異なります。
GPT-Realtime-Whisperは、話している音声をテキスト化するためのモデルです。会議の発言をリアルタイム字幕として表示したり、発話ごとにログとして保存したりする用途に向いています。
一方、GPT-Realtime-Translateは、入力された音声を別の言語へ翻訳するためのモデルです。日本語で話した内容を英語に変換したり、英語の発言を日本語字幕として表示したりする用途で活用できます。
今回作るアプリでは、GPT-Realtime-Whisperを「原文の文字起こし担当」、GPT-Realtime-Translateを「翻訳担当」として使います。
| モデル | 役割 | アプリ内での使いどころ |
|---|---|---|
| GPT-Realtime-Whisper | 音声をテキスト化する | 原文字幕、発話ログ、議事録素材 |
| GPT-Realtime-Translate | 音声やテキストを翻訳する | 翻訳字幕、翻訳音声、多言語会話 |
モデルそのものの説明はこの程度にとどめ、以降はアプリ制作の流れを中心に見ていきます。
作るアプリの完成イメージ
今回想定するのは、ブラウザ上でマイク音声を取得し、話した内容をリアルタイムで文字起こししながら、指定した言語へ翻訳するWebアプリです。
たとえば、日本語で話すと、画面には日本語の原文字幕と英語の翻訳字幕が表示されます。必要に応じて、翻訳された音声を再生することもできます。
ユーザーが日本語で話す
        ↓
マイク音声を取得
        ↓
GPT-Realtime-Whisperで日本語字幕を生成
        ↓
GPT-Realtime-Translateで英語へ翻訳
        ↓
画面に原文字幕と翻訳字幕を表示
        ↓
必要に応じて翻訳音声を再生・保存
最初から高機能な同時通訳アプリを作ろうとすると、音声処理、翻訳、UI、保存、認証などが複雑になります。そのため、最初のバージョンでは以下の機能に絞ると作りやすいです。
| 機能 | 内容 |
|---|---|
| マイク入力 | ブラウザから音声を取得する |
| 原文字幕 | 話した言語の文字起こしを表示する |
| 翻訳字幕 | 指定した言語の翻訳結果を表示する |
| ログ保存 | 確定した発話と翻訳結果を保存する |
| 言語選択 | 入力言語と翻訳先言語を選べるようにする |
この段階では、翻訳音声の再生や話者分離、議事録生成などは後回しで問題ありません。まずは「話す → 原文が出る → 翻訳が出る」という基本動作を安定させることが重要です。
基本アーキテクチャ
リアルタイム翻訳字幕アプリの構成は、以下のようになります。
[ブラウザ]
  ├─ マイク入力を取得
  ├─ 入力言語・翻訳先言語を選択
  ├─ 一時的な認証キーを取得
  ├─ WebRTCまたはWebSocketで接続
  ├─ 原文字幕を表示
  └─ 翻訳字幕を表示

[バックエンド]
  ├─ OpenAI APIキーを安全に保持
  ├─ Realtime API用の一時キーを発行
  ├─ 必要に応じてセッション設定を作成
  └─ ログ保存や要約処理を担当

[OpenAI Realtime API]
  ├─ 音声ストリームを受信
  ├─ GPT-Realtime-Whisperで文字起こし
  ├─ GPT-Realtime-Translateで翻訳
└─ delta / completedイベントを返却重要なのは、OpenAI APIキーをブラウザに直接書かないことです。ブラウザ側のJavaScriptはユーザーから見えるため、APIキーを埋め込むと不正利用されるリスクがあります。
そのため、バックエンド側でOpenAI APIキーを保持し、ブラウザには一時的なclient secretだけを渡す構成にします。この考え方は、リアルタイム文字起こしアプリでも重要な設計ポイントです。
処理フローを分けて考える
このアプリでは、音声を扱う処理が複数あります。最初にすべてを一体化して考えると複雑になるため、以下の3つに分けると整理しやすくなります。
1. 音声入力
2. 原文の文字起こし
3. 翻訳字幕の生成
1. 音声入力
ブラウザでマイク音声を取得します。
const stream = await navigator.mediaDevices.getUserMedia({
  audio: true
});
この音声ストリームをRealtime APIへ送信します。Webアプリでマイクを扱う場合はWebRTCが自然ですが、検証段階ではWebSocketで音声ファイルを送る構成から始めても構いません。
2. 原文の文字起こし
GPT-Realtime-Whisperで、入力音声をテキスト化します。
ここで重要なのは、途中経過と確定結果を分けることです。
deltaイベント      → 画面上のリアルタイム字幕
completedイベント  → 保存用の正式な発話ログ
途中経過はあとから修正される可能性があるため、保存用データには使わず、画面表示用として扱います。保存や翻訳処理には、基本的に確定した発話を使う方が安定します。
3. 翻訳字幕の生成
確定した発話テキスト、または音声ストリームをGPT-Realtime-Translateへ渡し、翻訳結果を取得します。
実装方針としては、主に2パターンあります。
| 方式 | 内容 | 向いているケース |
|---|---|---|
| 音声を直接翻訳する | 音声をGPT-Realtime-Translateへ送る | 低遅延の音声翻訳を重視する場合 |
| 文字起こし後に翻訳する | Whisperの確定テキストを翻訳する | ログ保存や字幕精度を重視する場合 |
最初に作るアプリでは、文字起こし後に翻訳する方式がわかりやすいです。原文ログと翻訳ログをセットで保存でき、後から修正や再翻訳もしやすくなります。
画面設計例
最初の画面は、できるだけシンプルで構いません。
┌──────────────────────────────────┐
│ リアルタイム翻訳字幕アプリ          │
├──────────────────────────────────┤
│ 入力言語:[日本語 ▼]               │
│ 翻訳先 :[英語 ▼]                 │
│ [開始] [停止] [保存]               │
├──────────────────────────────────┤
│ 現在の発話                         │
│ 本日は、リアルタイム翻訳アプリの... │
├──────────────────────────────────┤
│ 翻訳字幕                           │
│ Today, we will discuss...          │
├──────────────────────────────────┤
│ 確定済みログ                       │
│ 10:00 JA: 本日は...                │
│       EN: Today...                 │
├──────────────────────────────────┤
│ [Markdown出力] [議事録を生成]       │
└──────────────────────────────────┘
アプリのUIでは、原文と翻訳文を並べて表示すると使いやすくなります。
たとえば、会議用途では以下のように保存できます。
# リアルタイム翻訳ログ

## 2026-05-12 10:00

### 発話1
**原文**
本日は、リアルタイム翻訳アプリの構成について説明します。

**翻訳**
Today, I will explain the architecture of a real-time translation app.
この形式にしておくと、後から議事録化、要約、字幕ファイル化などに展開しやすくなります。
実装ステップ
ステップ1:バックエンドで一時キーを発行する
まず、Node.jsなどでバックエンドを用意します。
バックエンドの役割は、OpenAI APIキーを安全に保持し、ブラウザに一時的な接続情報を渡すことです。
import express from "express";

const app = express();
app.use(express.json());

app.get("/session", async (req, res) => {
  const response = await fetch("https://api.openai.com/v1/realtime/transcription_sessions", {
    method: "POST",
    headers: {
      "Authorization": `Bearer ${process.env.OPENAI_API_KEY}`,
      "Content-Type": "application/json"
    },
    body: JSON.stringify({
      input_audio_format: "pcm16",
      input_audio_transcription: {
        model: "gpt-realtime-whisper",
        language: "ja",
        prompt: "日本語の会議音声です。IT、AI、API、セキュリティ関連の専門用語が含まれます。"
      },
      turn_detection: {
        type: "server_vad",
        threshold: 0.5,
        prefix_padding_ms: 300,
        silence_duration_ms: 500
      }
    })
  });

  const data = await response.json();
  res.json(data);
});

app.listen(3000, () => {
  console.log("Server running on http://localhost:3000");
});
これは文字起こしセッションの例です。翻訳も同じアプリ内で扱う場合は、翻訳用のセッションや翻訳処理を追加します。
ステップ2:ブラウザでマイク入力を取得する
ブラウザ側では、マイク利用許可を取得し、音声ストリームを扱います。
async function startMic() {
  const stream = await navigator.mediaDevices.getUserMedia({
    audio: true
  });

  return stream;
}
実際のアプリでは、開始ボタンを押したときにこの処理を実行します。
document.getElementById("startButton").addEventListener("click", async () => {
  const stream = await startMic();
  console.log("Microphone started", stream);
});
この段階では、まだRealtime APIへ送らず、マイクが正しく取得できるかだけ確認します。音声アプリでは、API接続より先にマイク権限やブラウザ対応でつまずくことも多いためです。
ステップ3:文字起こし結果を表示する
Realtime APIから返るイベントを受け取り、途中結果と確定結果を分けます。
const finalLogs = [];

function handleTranscriptionEvent(event) {
  if (event.type === "conversation.item.input_audio_transcription.delta") {
    document.getElementById("partialText").textContent = event.delta;
  }

  if (event.type === "conversation.item.input_audio_transcription.completed") {
    finalLogs.push({
      id: event.item_id,
      original: event.transcript,
      translated: ""
    });

    renderLogs();
  }
}ポイントは、deltaをそのまま保存しないことです。deltaは字幕の途中表示には便利ですが、文章が後から変わる可能性があります。保存や翻訳の基準には、確定結果であるcompletedイベントを使うと整理しやすくなります。
ステップ4:確定した原文を翻訳する
次に、completedイベントで確定した原文を翻訳します。
async function translateText(text, targetLanguage) {
  const response = await fetch("/translate", {
    method: "POST",
    headers: {
      "Content-Type": "application/json"
    },
    body: JSON.stringify({
      text,
      targetLanguage
    })
  });

  const data = await response.json();
  return data.translatedText;
}
バックエンド側では、GPT-Realtime-Translate、または翻訳に使えるモデルを呼び出して翻訳結果を返します。
app.post("/translate", async (req, res) => {
  const { text, targetLanguage } = req.body;

  // 実際にはここでOpenAI APIを呼び出して翻訳する
  const translatedText = await translateWithOpenAI(text, targetLanguage);

  res.json({ translatedText });
});
最初の実装では、原文が確定してから翻訳する方式にしておくと、ログ管理が簡単です。リアルタイム性をさらに高めたい場合は、翻訳もストリーミング化し、翻訳の途中結果を画面に表示する構成へ拡張できます。
保存データの設計
翻訳字幕アプリでは、保存データの設計が重要です。
単に翻訳文だけを保存すると、あとから原文との対応関係を確認しにくくなります。そのため、少なくとも以下の情報をセットで保存すると便利です。
| 項目 | 内容 |
|---|---|
| id | 発話単位のID |
| startedAt | 発話開始時刻 |
| completedAt | 発話確定時刻 |
| sourceLanguage | 入力言語 |
| targetLanguage | 翻訳先言語 |
| originalText | 原文 |
| translatedText | 翻訳文 |
保存データの例は以下です。
{
  "id": "item_001",
  "startedAt": "2026-05-12T10:00:00+09:00",
  "completedAt": "2026-05-12T10:00:04+09:00",
  "sourceLanguage": "ja",
  "targetLanguage": "en",
  "originalText": "本日は、リアルタイム翻訳アプリの構成について説明します。",
  "translatedText": "Today, I will explain the architecture of a real-time translation app."
}
この形式にしておけば、Markdown出力、CSV出力、字幕ファイル生成、議事録化などに展開しやすくなります。
VAD設定と翻訳タイミング
リアルタイム翻訳アプリでは、どのタイミングで翻訳するかが重要です。
発話が短く切れすぎると、翻訳文が不自然になりやすくなります。逆に、長く待ちすぎると、字幕や翻訳の表示が遅れます。
たとえば、次のような調整が必要です。
| 状況 | 起こる問題 | 調整方法 |
|---|---|---|
| 無音判定が短すぎる | 文が細切れになる | silence_duration_msを長くする |
| 無音判定が長すぎる | 翻訳表示が遅れる | silence_duration_msを短くする |
| 専門用語が多い | 誤変換・誤訳が増える | promptや用語集を追加する |
| 会話のテンポが速い | 翻訳が追いつかない | 発話単位を短めにする |
| 講演やセミナー | 文脈が長い | 少し長めに区切る |
会議や日常会話なら、短めの発話単位が向いています。一方、セミナーや講演では、少し長めに区切った方が文脈を保ちやすくなります。
専門用語や固有名詞への対応
翻訳字幕アプリでは、専門用語や固有名詞の扱いが品質に大きく影響します。
たとえば、IT系の会議では次のような用語が出てきます。
Realtime API
WebRTC
WebSocket
GPT-Realtime-Whisper
GPT-Realtime-Translate
CVE
EDR
SIEM
ゼロトラスト
イミュータブルバックアップ
これらを毎回正しく文字起こし・翻訳するには、アプリ側で用語リストを持たせると便利です。
{
  "terms": [
    {
      "source": "イミュータブルバックアップ",
      "target": "immutable backup",
      "note": "削除や改ざんができないバックアップ"
    },
    {
      "source": "ゼロトラスト",
      "target": "zero trust",
      "note": "すべてのアクセスを検証するセキュリティ考え方"
    }
  ]
}
この用語リストをセッションのpromptや翻訳指示に含めることで、文字起こしと翻訳の一貫性を高められます。
段階的な開発ロードマップ
個人開発や検証目的で作る場合は、以下の順番がおすすめです。
フェーズ1:文字起こしだけを動かす
まずは翻訳を入れず、GPT-Realtime-Whisperで文字起こしだけを動かします。
マイク音声
 ↓
GPT-Realtime-Whisper
 ↓
原文字幕を表示
この段階では、マイク取得、API接続、delta / completedイベントの扱いを確認します。
フェーズ2:確定テキストを翻訳する
次に、completedイベントで確定した文章を翻訳します。
確定した原文
 ↓
翻訳処理
 ↓
翻訳字幕を表示
最初は、発話が確定してから翻訳する方式で十分です。
フェーズ3:原文と翻訳文を保存する
原文と翻訳文をセットで保存できるようにします。
completedイベント
 ↓
原文・翻訳文・時刻を保存
 ↓
Markdown / JSONで出力
この段階まで作ると、会議ログや字幕原稿として使えるようになります。
フェーズ4:リアルタイム翻訳音声を追加する
字幕表示が安定したら、翻訳音声の再生を追加します。
翻訳結果
 ↓
音声として再生
この機能を入れると、同時通訳アプリに近づきます。ただし、音声再生まで含めると遅延や会話のかぶりを考慮する必要があるため、字幕版が安定してから追加するのがおすすめです。
フェーズ5:議事録化や字幕ファイル出力を追加する
最後に、保存したログをもとに議事録生成や字幕ファイル出力を追加します。
原文・翻訳ログ
 ↓
要約モデル
 ↓
概要・決定事項・ToDo
また、動画制作向けであれば、SRTやVTT形式で字幕ファイルを書き出す機能も便利です。
実装時につまずきやすいポイント
リアルタイム翻訳字幕アプリでは、以下の点でつまずきやすくなります。
| つまずきポイント | 対策 |
|---|---|
| APIキーをブラウザに書いてしまう | バックエンドで一時キーを発行する |
| 原文字幕と翻訳字幕がずれる | item_idで発話単位を紐づける |
| deltaを保存してしまう | 保存はcompletedイベントを使う |
| 翻訳が細切れになる | VAD設定を調整する |
| 翻訳表示が遅い | 発話区切りを短くする |
| 固有名詞が誤訳される | 用語リストをpromptに含める |
| 会話ログが読みにくい | 原文・翻訳・時刻をセットで保存する |
| コストが読みにくい | 文字起こし・翻訳・要約を分けて試算する |
特に重要なのは、原文と翻訳文を同じ発話IDで管理することです。これをしないと、会話が長くなったときに、どの原文にどの翻訳が対応しているのか分かりにくくなります。
どんな用途に向いているか
GPT-Realtime-WhisperとGPT-Realtime-Translateを組み合わせたアプリは、以下のような用途に向いています。
| 用途 | 活用イメージ |
|---|---|
| 多言語会議 | 原文と翻訳字幕を同時表示する |
| 海外商談 | 相手の発言を日本語化し、自分の発言を英語化する |
| ウェビナー | 登壇内容を多言語字幕として表示する |
| オンライン授業 | 講義内容を翻訳字幕付きで提供する |
| カスタマーサポート | 顧客の言語をオペレーターの言語に翻訳する |
| 動画制作 | 原文字幕と翻訳字幕の素材を作成する |
| インタビュー | 多言語インタビューの文字起こしと翻訳を同時に行う |
特に、会話ログを保存できる点は大きなメリットです。単なる通訳アプリではなく、後から検索・要約・共有できる「多言語コミュニケーション記録ツール」として発展させられます。
まとめ
GPT-Realtime-WhisperとGPT-Realtime-Translateを組み合わせると、話した内容をリアルタイムに文字起こしし、別の言語へ翻訳するアプリを作ることができます。
実装では、まずGPT-Realtime-Whisperで原文字幕を安定して表示し、その後、確定した発話をGPT-Realtime-Translateで翻訳する構成にすると作りやすくなります。途中経過のdeltaイベントは画面表示用、completedイベントは保存用として扱うと、ログ管理も整理しやすくなります。
最初から音声翻訳や話者分離まで入れると複雑になるため、まずは「マイク入力」「原文字幕」「翻訳字幕」「ログ保存」の4機能に絞るのがおすすめです。その後、翻訳音声の再生、議事録生成、用語補正、字幕ファイル出力などを段階的に追加すると、実用的なリアルタイム翻訳字幕アプリへ発展させられます。

コメント